AIVISION Speech-to-Text E1.0: Transcripción en GPU
28/09/2026
AIVISION presenta Speech-to-Text E1.0 (código de compilación aivision-s2s-ev-E1.0.0), un modelo de reconocimiento de voz en vietnamita con 1.5 mil millones de parámetros. El modelo procesa frases donde se intercala inglés en medio y es lo suficientemente pequeño para ejecutarse en una sola GPU o directamente en el dispositivo.
Pruebe la herramienta e integre la API en s2s.aivgroups.com.
Cifras clave
| Métrica | Valor | Nota |
|---|---|---|
| WER promedio | 11,84% | En 4 conjuntos de prueba reservados. Menor es mejor. |
| Voz leída en vietnamita | 4,58% | FLEURS-vi |
| Hablado mixto vietnamita + inglés | 15,68% | ViMedCSS (médico), mantiene la terminología en inglés |
Modelo de 1.5B parámetros, entrenado con más de 50,000 horas de audio en vietnamita, incluyendo lectura, radio y conversaciones naturales.
Precisión por conjunto de prueba
WER (Word Error Rate) comparado con la transcripción humana, en cuatro conjuntos de prueba en vietnamita. Menor es mejor.
| Conjunto de prueba | Tipo de datos | WER% |
|---|---|---|
| FLEURS-vi | Lectura en vietnamita | 4,58 |
| VIVOS | Lectura en vietnamita | 6,83 |
| ViMedCSS test | Médico, hablado mixto vietnamita + inglés | 15,68 |
| AIV meetings | Reuniones reales, habla natural, lejos del micrófono | 20,29 |
| Promedio | 11,84 |
El conjunto AIV meetings es el más difícil porque son conversaciones reales, con varias personas hablando a la vez y grabadas desde lejos. Este es el tipo de audio que las empresas encuentran con mayor frecuencia al transcribir reuniones.
Comparación con otros modelos de código abierto
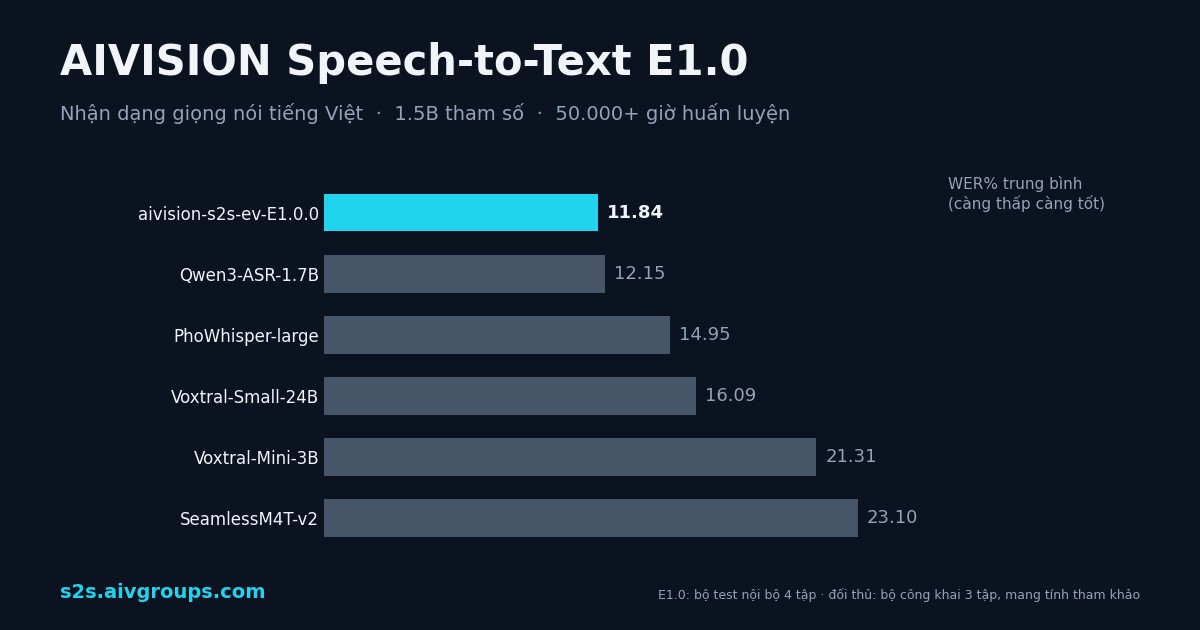
Realizamos nuestra propia prueba en tres conjuntos de prueba públicos en vietnamita (FLEURS-vi, VIVOS, ViMedCSS), con 300 frases por conjunto, el 29/08/2026.
| # | Modelo | Parámetros | WER% Prom. |
|---|---|---|---|
| 1 | aivision-s2s-ev-E1.0.0 | 1.5B | 11,84* |
| 2 | Qwen3-ASR-1.7B | 1.7B | 12,15 |
| 3 | PhoWhisper-large | 1.5B | 14,95 |
| 4 | Voxtral-Small-24B | 24B | 16,09 |
| 5 | Voxtral-Mini-3B | 3B | 21,31 |
| 6 | SeamlessM4T-v2 | 2.3B | 23,10 |
PhoWhisper-large es el mejor en lectura pura en vietnamita (VIVOS 4,79) pero el más débil cuando el hablante intercala inglés.
* Nota sobre la comparación: las cifras de los otros modelos se midieron en el conjunto de tres pruebas públicas. La cifra de 11,84 de E1.0 se midió en un conjunto de cuatro conjuntos internos, más difícil por incluir audio de reuniones AIV. Por lo tanto, el ranking es solo referencial, no es una comparación estricta en el mismo conjunto de pruebas.
Por qué elegir E1.0
- Vietnamita cercano a la transcripción humana. La lectura limpia alcanza un WER de 4,58 en FLEURS-vi y 6,83 en VIVOS.
- Inglés dentro de frases en vietnamita. Mantiene la terminología técnica en inglés en lugar de transcribirla incorrectamente: WER de 15,68 en el conjunto médico de habla mixta, donde los modelos que solo aprenden vietnamita suelen fallar más.
- Lo suficientemente pequeño para autoalojamiento. 1.5B parámetros que se ejecutan en una GPU o en el dispositivo. Los datos de audio no salen de su sistema, no requiere servidores masivos y no incurre en costos de nube por minuto.
Método de evaluación
- Audio fijo de 16 kHz, comparado con la transcripción humana.
- Los números se leen en texto en ambos lados, el WER se calcula de la misma manera en todos los conjuntos de prueba.
- La precisión en inglés se reporta actualmente como inglés intercalado en vietnamita. Aún no publicamos el WER para inglés puro.
Prueba
Visite s2s.aivgroups.com para probar el modelo y ver la documentación de la API. Si necesita asesoría para implementación local en su empresa, contacte al equipo de AIVISION.