Clúster de 24 GPU H200 para entrenar un LLM: cómo funciona
01/10/2026
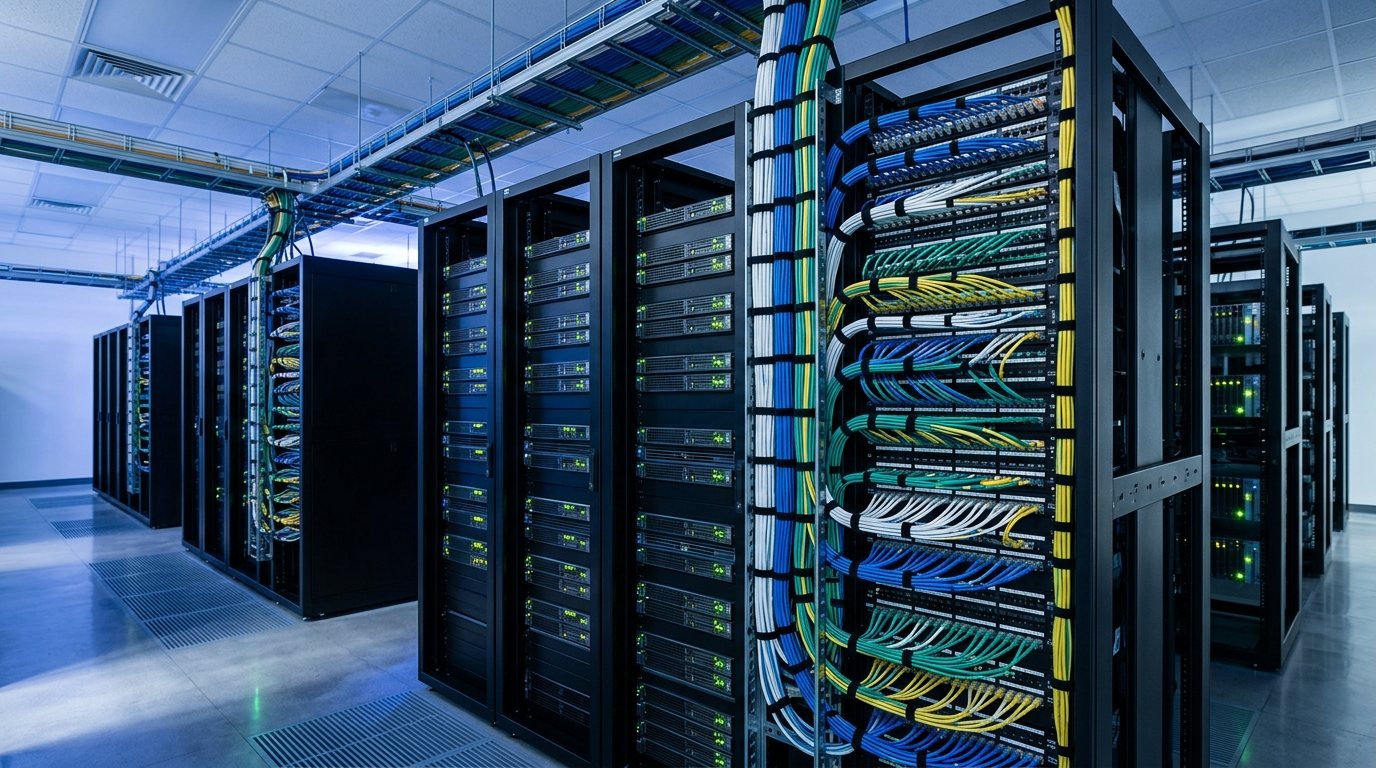
Imaginen que tienen que copiar a mano una biblioteca enorme en una sola noche. Una persona nunca alcanzaría, así que llaman a más gente y le asignan unos cuantos libreros a cada una. Pero al repartir el trabajo surgen problemas nuevos: quién guarda el original, quién revisa los errores, cómo se comunican todos sin perder la tarde entera. Entrenar un modelo de lenguaje de gran tamaño en el clúster de 24 GPU H200 de AIVISION se parece a eso, solo que los copistas son chips y las páginas son miles de millones de números.
Qué es una GPU H200, sin tecnicismos
La H200 es una GPU de NVIDIA diseñada para cómputo de IA a gran escala. Dos datos públicos vale la pena recordar: cada una tiene 141 GB de memoria HBM3e y un ancho de banda de memoria de unos 4.8 TB/s. Pueden pensar en la memoria como el escritorio de trabajo y en el ancho de banda como lo ancho del pasillo por el que se llevan los documentos al escritorio. Mientras más grande el escritorio, más cosas caben a la vez; mientras más ancho el pasillo, menos tiempo pasa esperando quien trabaja.
En un LLM, esperar es el enemigo principal. Durante el entrenamiento, gran parte del tiempo de un chip no se usa para calcular, sino para esperar que lleguen los datos desde la memoria. Por eso el ancho de banda importa casi tanto como la potencia de cálculo pura.
Sumando, 24 GPU de 141 GB cada una dan unos 3.3 TB de memoria de GPU en todo el clúster. Esta cifra es una multiplicación hecha a partir de las especificaciones públicas, no una medición propia, y tampoco dice qué tan grande es el modelo que se puede ejecutar, porque la memoria debe alojar muchas otras cosas además del modelo.
Por qué una sola GPU no alcanza
Al entrenar, la memoria no guarda solo los pesos del modelo. También contiene los resultados intermedios de cada paso de cálculo, los gradientes para actualizar el modelo y el estado del optimizador. Con todo eso, la necesidad de memoria es varias veces mayor que el tamaño del modelo. Por potente que sea, una GPU pronto llega a su límite.
La solución es repartir el trabajo. Hay varias formas de hacerlo, y los ingenieros suelen combinarlas:
- Dividir los datos: cada GPU conserva una copia del modelo y procesa un lote de datos distinto; después todo el grupo suma los resultados.
- Dividir el modelo: se separan las capas, o cada operación grande, entre varias GPU cuando una sola no puede contener el modelo completo.
- Dividir el estado del entrenamiento: se distribuyen los gradientes y el estado del optimizador entre varias máquinas para que cada una cargue menos.
Todas estas formas tienen el mismo precio: las GPU deben comunicarse entre sí todo el tiempo. Por eso la red que las conecta es tan importante como los chips. Un clúster con GPU excelentes pero con una red lenta es como un equipo de copistas muy hábiles que solo se comunican por carta.
Cómo es un día de entrenamiento
La verdad es que la mayor parte del tiempo de un ingeniero no se va en admirar una curva de pérdida que baja bonito. Una corrida larga suele contar una historia mucho más desordenada. Hay días en que un nodo se cuelga por un error menor, todo el trabajo se detiene y hay que retomarlo desde el último checkpoint. Hay días en que la pérdida se dispara de pronto y se van medio turno buscando si fue un lote de datos sucio o una tasa de aprendizaje demasiado alta.
Por eso los checkpoints, es decir, guardar el estado de forma periódica, son un hábito vital. Si se guarda con frecuencia se pierde tiempo escribiendo en disco; si se guarda poco, un fallo cuesta mucho trabajo. Es un compromiso típico y no existe una respuesta correcta para todos los clústeres. Cada equipo tiene que encontrar el equilibrio para su propio sistema.
Otro tema del que se habla poco es el costo de operación. Un clúster de 24 GPU consume mucha electricidad y genera mucho calor, lo que trae consigo enfriamiento, respaldo de energía y monitoreo. No entramos en cifras aquí, pero quien piense que tener GPU es comprarlas y encenderlas debería platicar con quien opera un centro de datos.
Para qué sirve el H200 en AIVISION
El clúster H200 es la parte pesada del proceso de entrenamiento y fine-tuning de LLM en vietnamita. Etapas como continuar el entrenamiento con datos en vietnamita, hacer fine-tuning para sectores como salud o farmacia, y repetir experimentos cuando cambia el tratamiento de los datos requieren muchas horas de GPU continuas.
No indicamos aquí qué modelo se entrenó durante cuánto tiempo ni con cuántos tokens, porque es información que aún no hemos publicado. Lo que sí se puede decir en general es que, para el fine-tuning de LLM, la ventaja de tener un clúster propio es la capacidad de decidir. Si el equipo de datos termina de limpiar un lote de documentos médicos por la tarde, esa misma noche se puede lanzar una prueba y ver los resultados a la mañana siguiente. Ese ciclo corto de retroalimentación vale más de lo que se piensa.
Una nota importante sobre salud: aunque se haga fine-tuning para salud y farmacia, el objetivo es apoyar la información y la administración. El modelo no diagnostica, no receta, no recomienda dosis, y el criterio médico siempre tiene la decisión final.
Compromisos que conviene conocer
Un clúster grande no siempre es la respuesta. En experimentos pequeños, coordinar 24 GPU cuesta más trabajo que correrlos en unas cuantas. A veces una idea debe probarse primero a pequeña escala, y solo las que sobreviven pasan al clúster grande.
Además, el clúster H200 y el clúster B300 de AIVISION se usan para tareas distintas. La B300, con unos 288 GB de HBM3e por GPU, tiene sus propios usos, que explicamos en el artículo sobre Blackwell Ultra. Repartir bien el trabajo entre ambos grupos también es parte del oficio.
Si están evaluando construir su propia infraestructura o contratar un servicio externo para un proyecto de IA en Vietnam, nuestro consejo más práctico es medir primero la necesidad real. Cuántas horas de GPU al mes, si la carga es constante o irregular, si cuentan con un equipo de operación. Estas tres preguntas definen la mayor parte de la decisión, y no tienen nada que ver con el chip que más se anuncie.
Pueden conocer más sobre nuestra forma de trabajar en AIVISION.